"OSWorld:在真实计算机环境中评测多模态智能体的开放式任务能力"
"OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments"
推荐全译对照查看原文(PDF) ↗
译注:本对照翻译覆盖论文正文部分——标题与作者、摘要、第 1 节(引言)、第 2 节(OSWorld 环境)、第 3 节(OSWorld 基准)、第 4 节(基线评测)、第 5 节(分析)、第 6 节(相关工作)、第 7 节(结论与未来工作)及致谢,对应 arXiv v2 版 PDF 第 1–18 页。其后的 References(参考文献)与附录 A–D 未收录:附录 A 为环境基础设施细节、观察空间(截图与无障碍树)与动作空间(pyautogui 完整动作列表、computer_13 变体);附录 B 为操作系统与软件选择、任务来源、样例收集、初始状态设置与评估配置细节及更多任务示例;附录 C 为基线超参数、提示词细节、无障碍树过滤、SoM 实现细节与完整结果表;附录 D 为成功/失败案例、GPT-4V 常见错误、难度错位与 Claude-3 对比的扩展定性分析。图表方面:图 2 的任务配置 JSON、表 1 的评估脚本以代码块保留;表 2–表 7(动作示例、任务统计、基准对比、主结果、子集成功率、跨 OS 对比)已转为 markdown 并保留全部数值;图 1、3–10 以图题加中文说明的方式收录。完整内容请查阅原文与项目主页 https://os-world.github.io 。
要点速览
- 动机:已有智能体基准要么无可执行环境(非执行式评估惩罚替代正确解),要么局限于网页/代码等单一域;真实计算机使用是跨应用、跨 GUI/CLI 的,需要一个真实、可扩展的统一环境。
- 环境:首个基于虚拟机的真实计算机环境,支持 Ubuntu/Windows/macOS;配置文件驱动"初始状态设置→交互→后处理→取回数据→执行评估"全流程;VM 提供安全隔离与快照重置,单机可并行多 VM、支持无头运行。
- 任务形式化:POMDP;观察 = 截图/a11y 树/终端输出;动作 = pyautogui 代码(全部键鼠动作,可嵌入循环)+ WAIT/FAIL/DONE;奖励为执行式 0,1;实验最大 15 步。
- 基准构建:369 个 Ubuntu 任务 + 43 个 Windows 任务;来源覆盖教程、论坛、视频课程等真实场景;每例标注初始状态配置与定制评估脚本;9 名作者 3 个月约 1800 人时(另有约 400 人时整合外部 84 例、超 400 人时四轮复查)。
- 任务构成:单应用 268(72.6%)/ 多应用工作流 101(27.4%);不可行任务 30(8.1%);整合 NL2Bash、Mind2Web、SheetCopilot、PPTC、GAIA 共 84 例(22.8%);302 个初始状态、134 个独特评估函数(远超 WebArena 的 5、WebShop 的 1)。
- 人类基线:完成时间中位数 111.94 秒(WebArena 35.38 秒),准确率 72.36%(WebArena 88%)——任务更难更耗时。
- 主结果:全部基线成功率 0.99%–12.24%;最好为无障碍树输入的 GPT-4(12.24%);纯截图下 GPT-4V 仅 5.26%;多应用工作流最好仅 6.57%;LibreOffice Calc 子集经常 0 分;人类 72.36% 全面碾压且跨任务类型稳定(±5%),模型方差却极大。
- 输入法对比:a11y 树对 GPT-4V 大幅加分(5.26%→12.17%)但对 Gemini 反而减分;SoM 在 OS 上因高分辨率、元素过多、噪声大而失效;纯截图虽最弱,但因无需额外信息、贴近人类感知,应是长期终极配置。
- 关键分析:难度分组成功率 16.78%/13.12%/4.59%(人 84.91%/81.08%/49.57%);分辨率提升普遍涨分(SoM 在 0.4 倍降采样处最佳);文本历史越长越好但图像历史无效(90% 单观察约需 6000 token);窗口位置/大小/遮挡扰动使成功率从 50.79% 跌 60–80%;Ubuntu 4.88% vs Windows 2.55%,相关系数 0.7。
- 失败模式:550 个失败样本中 >75% 有鼠标点击不准("规划强、执行弱"),派生重复点击与环境噪声困境;缺乏软件先验(GIMP 亮度菜单找不到);Claude-3 规划好但 grounding 幻觉多(双击当单击、B 列当 C 列);难度错位:人难的代码任务智能体易、人易的设计排版任务智能体难,且用 ffmpeg 替代"用 GIMP"这类偏离指令的行为值得警惕。
- 未来方向:更强 GUI 定位与长上下文 VLM、探索/记忆/反思架构与个性化、真实环境安全评估(现有评估只看任务结果、不管副作用)、数据与环境扩展——其中"智能体安全度量缺失"与"操作数据无痛采集"正是本讲两篇论文(与下一篇 WebShop)所代表的基准研究仍在推进的开放问题。
🖼 原文图表(25 张)—— 提取自原始文献,点击展开
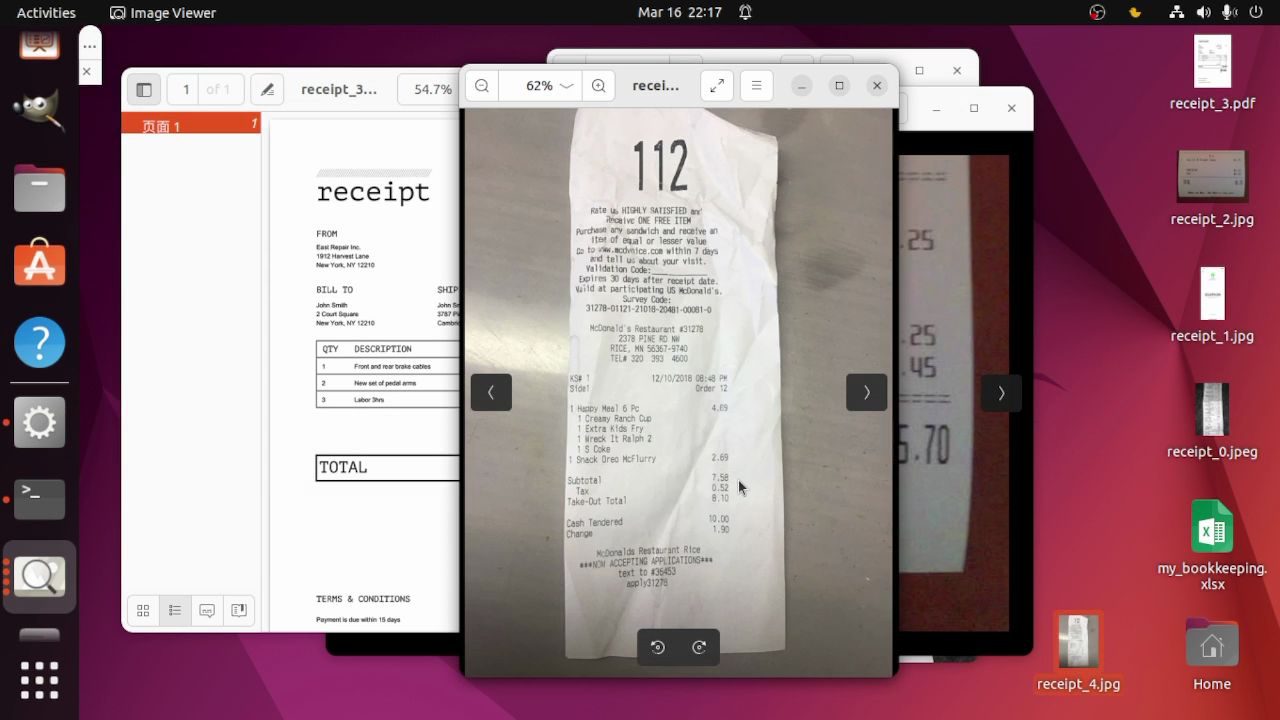
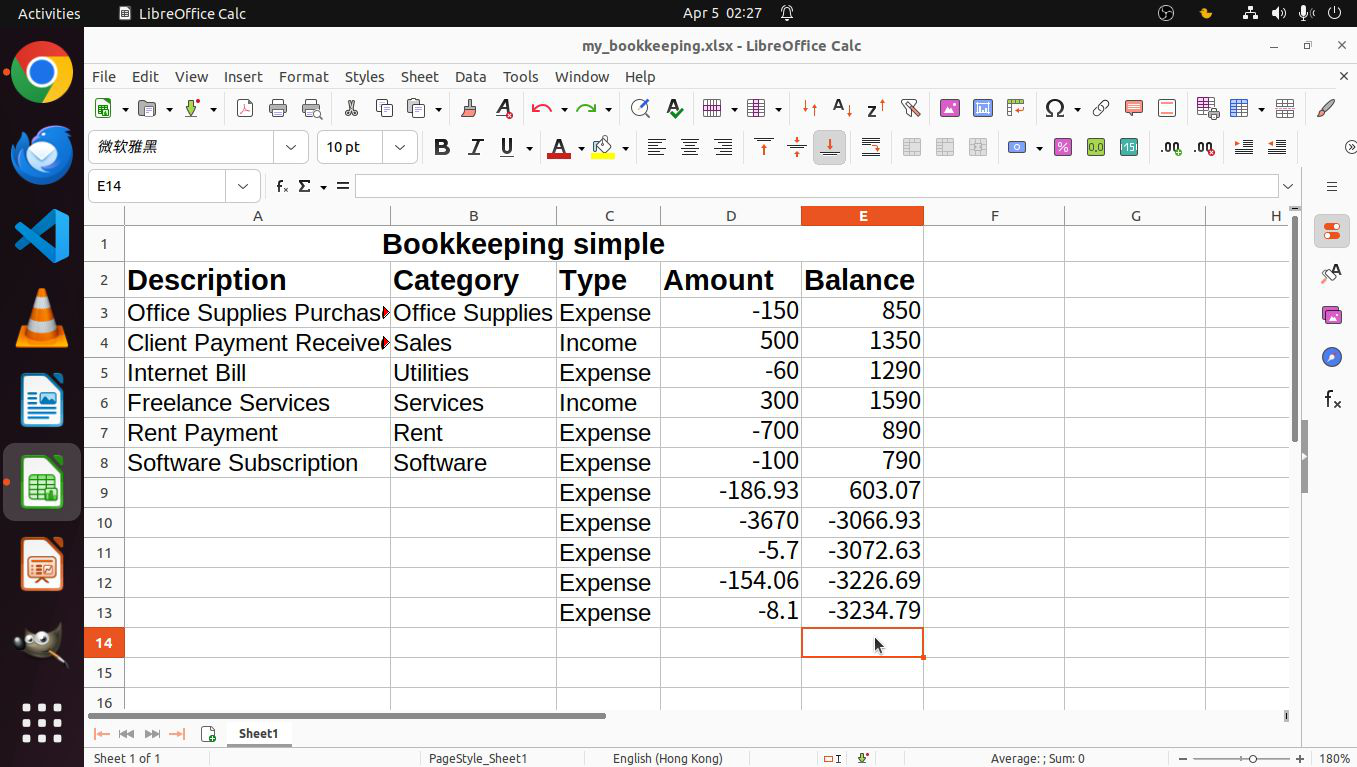
以上图片提取自原始 PDF/网页或 arXiv 官方 HTML 版(含矢量图与原始图注),已镜像至本站;与正文的对应关系请以原文为准。